Najważniejsze wyniki
- Dla artykułów z DOI zarejestrowanym w Crossref lub OpenAlex użycie modelu językowego jest zbędne. Bezpłatne zapytanie do rejestru (0.828) przewyższa każdy z 9 modeli (0.61–0.69), których użycie wiąże się ponadto z kosztami.
- Spośród modeli najwyższą trafność osiąga model najtańszy.
gemini-3.1-flashprzy koszcie 3,50 USD za 960 dokumentów przewyższa modele 14–20-krotnie droższe. - Różnice między językami są rzeczywiste, lecz częściowo wynikają z narzędzi, a nie z modeli. Co czwarty japoński plik PDF ma uszkodzoną warstwę tekstową. Modele przetwarzające tekst zamiast obrazu tracą na tych plikach ok. 80% trafności w polach tytułu i autorów. Z kolei 30 punktów spadku trafności japońskich tytułów jest artefaktem metryki dzielącej tekst według spacji.
- Część pól nie występuje w treści PDF. ISSN jest wydrukowany jedynie w 38% artykułów. Model, który zawsze udziela odpowiedzi, generuje w takich polach błędy.
1. Cel i zakres badania
System CRIS (Current Research Information System) jest uczelnianą bazą dorobku naukowego, rejestrującą autorów, tytuły, miejsca i daty publikacji. Rekord przydatny w sprawozdawczości i ewaluacji wymaga kilkunastu pól: tytułu, autorów, roku, DOI, czasopisma, wydawcy, ISSN, stron, języka, słów kluczowych i abstraktu. W praktyce pola te są przepisywane ręcznie z pliku PDF lub kopiowane z rejestru. Przy kilku tysiącach publikacji rocznie w jednej uczelni jest to praca kosztowna i żmudna.
Pytanie badawcze brzmi: czy duże modele językowe mogą przejąć to zadanie i czy wykonują je lepiej niż narzędzia już dostępne? Większość dotychczasowych ewaluacji obejmuje artykuły anglojęzyczne kilku dużych wydawnictw. Systemy CRIS w Europie i Azji przetwarzają jednak również polskie zeszyty naukowe, japońskie biuletyny towarzystw naukowych i indonezyjskie czasopisma publikowane w systemie OJS. Z tego względu korpus zaprojektowano z myślą o różnorodności.
2. Metoda
2.1. Korpus
Korpus jest stratyfikowany: do każdej komórki (rok × język × dziedzina OpenAlex) wylosowano dokładnie pięć artykułów w otwartym dostępie:
Języki: angielski, hiszpański, portugalski, francuski, niemiecki, włoski, polski, indonezyjski, koreański, chiński, japoński i arabski. Komórka arabska zawierała zbyt mało referencji możliwych do rozwiązania, dlatego wnioski międzyjęzykowe dotyczą jedenastu języków.
2.2. Porównywane systemy
Porównano dziewięć modeli: gemini-3.1-flash, gemini-3.1-pro, gemma-4-31b, claude-sonnet-4.6, gpt-5.4, deepseek-v3.2, qwen-3.5-max, ministral-8b i qwen-3.5-7b. Wszystkie otrzymują ten sam prompt i ten sam zestaw stron. Zestaw jest przycinany indywidualnie dla każdego dokumentu: obejmuje początkowe i końcowe strony artykułu, tak aby uwzględnić każde miejsce, w którym analiza wstępna wykazała obecność metadanych. Zmniejsza to liczbę stron średnio o 37% bez utraty informacji. Istotne dla dalszej analizy jest to, że modele wizyjne otrzymują plik PDF, natomiast trzy modele wyłącznie tekstowe (DeepSeek i oba modele Qwen) otrzymują tekst wyodrębniony z tych samych stron.
2.3. Miara trafności
Ręcznie zweryfikowany zbiór wartości wzorcowych dla wszystkich 960 prac nie jest jeszcze dostępny; zostanie opracowany na etapie złotego zbioru (96 prac, dwóch anotatorów). Na etapie przesiewowym każde pole porównywane jest z dwiema niezależnymi referencjami: metadanymi ze strony wydawcy (A) i z OpenAlex (B). Podobieństwo pojedynczej wartości \(v\) do referencji \(r\) zależy od typu pola:
Pola ścisłe to DOI, rok, ISSN, strony i język; pola tekstowe to tytuł, czasopismo, wydawca i abstrakt. \(J\) oznacza indeks Jaccarda, \(T(\cdot)\) zbiór tokenów (podział według białych znaków), a \(\nu\) funkcję normalizującą nazwisko. Funkcje \(T\) i \(\nu\) mają istotne znaczenie dla analizy wyników w języku japońskim (zob. p. 6.3). Główną miarą jest trafność warunkowa względem dostępności: uwzględnia się wyłącznie komórki (dokument × pole), dla których co najmniej jedna referencja zawiera wartość:
Brak odpowiedzi jest liczony jako 0. Tak zdefiniowana trafność rozkłada się dokładnie na dwa czynniki: częstość udzielania odpowiedzi (pokrycie \(\varphi\)) oraz trafność odpowiedzi udzielonych:
Rozkład ten wykorzystano w analizie, czy model powinien mieć możliwość odmowy odpowiedzi (zob. p. 3.2).
3. Wyniki zbiorcze
Trafność systemów na 960 artykułach
avail-cond-acc, max(A, B); koszt wyświetlany po wskazaniu słupka kursorem
| system | trafność | pokrycie | acc | filled | koszt (960 dok.) |
|---|---|---|---|---|
| B0 rejestr | 0.828 | 85.6% | 0.919 | $0 |
| gemini-3.1-flash | 0.691 | 98.8% | 0.697 | $3.50 |
| gemini-3.1-pro | 0.669 | 97.6% | 0.679 | $71.98 |
| gemma-4-31b | 0.654 | 95.5% | 0.676 | $18.65 |
| claude-sonnet-4.6 | 0.650 | 81.3% | 0.766 | $71.89 |
| gpt-5.4 | 0.650 | 82.8% | 0.756 | $47.98 |
| deepseek-v3.2 | 0.639 | 80.4% | 0.761 | $2.89 |
| qwen-3.5-max | 0.629 | 84.6% | 0.723 | $13.83 |
| ministral-8b | 0.612 | 83.5% | 0.713 | $19.08 |
| B1 GROBID | 0.291 | 40.2% | 0.681 | $0 |
| B2 Docling | 0.279 | 51.7% | 0.512 | $0 |
| qwen-3.5-7b | 0.270 | 39.4% | 0.665 | $0 |
Wynik jest jednoznaczny: w przypadku artykułów już opublikowanych najskuteczniejszą metodą pozyskania metadanych jest rezygnacja z ich ekstrakcji. Gdy dokument ma DOI zarejestrowany w Crossref i OpenAlex, pojedyncze zapytanie HTTP daje trafność 0.828, a w polach, które rejestr zawiera, trafność sięga 0.919.
Wynik ten obowiązuje jednak warunkowo. B0 jest wyszukiwaniem, a nie ekstraktorem. Dla preprintu, raportu, rozprawy lub świeżo zdeponowanego pliku, którego rejestr jeszcze nie zawiera, B0 zwraca zero. W takich przypadkach pozostają modele, a ich trafność 0.61–0.69 stanowi jedyną praktyczną możliwość.
3.1. Koszt a trafność
Koszt a trafność modeli LLM
każdy punkt odpowiada jednemu modelowi na pełnym korpusie 960 dokumentów
gemini-3.1-flash, kosztował 3,50 USD za cały korpus (ok. 0,4 centa za artykuł). claude-sonnet-4.6 i gemini-3.1-pro kosztowały po ok. 72 USD i osiągnęły niższy wynik. W zadaniu ograniczonym schematem zdolności rozumowania najdroższych modeli nie przekładają się na wyższą trafność.3.2. Pokrycie a precyzja odpowiedzi
Dane w tabeli ujawniają wyraźny podział. Modele Gemini i Gemma wypełniają 95–99% pól. Modele Claude, GPT i DeepSeek wypełniają ok. 80–83% pól, lecz udzielone przez nie odpowiedzi są znacznie częściej poprawne (0.76 wobec 0.68–0.70).
Pokrycie a precyzja
oś X: odsetek wypełnionych pól; oś Y: trafność obliczona wyłącznie dla pól wypełnionych
Ocena, który model jest właściwszy, zależy od kosztu późniejszej weryfikacji. Dla bibliotekarza weryfikującego rekordy puste pole oznacza dwie sekundy pracy. Błędny ISSN podany bez sygnału niepewności to błąd, który może trafić do sprawozdania. Wybór strategii wymaga zatem odpowiedzi na pytanie, czy dana informacja w ogóle występuje w pliku PDF.
4. Obecność metadanych w treści dokumentu
Dla każdego pola zbadano, jak często wartość referencyjną można odnaleźć w tekście samego dokumentu. Miarą jest wskaźnik odzyskiwalności (recoverability):
Odsetek artykułów zawierających wartość pola w treści
odzyskiwalność Rf na 960 dokumentach; kolor morski: pola często nieobecne w pliku PDF
Zmienia to interpretację wyników dla poszczególnych pól. Model, który nie podaje poprawnego ISSN, w większości przypadków nie ma dostępu do tej wartości w dokumencie. Z tego powodu rejestr uzyskuje przewagę właśnie w polach ISSN, DOI i wydawca: zawiera te dane również wtedy, gdy PDF ich nie zawiera. Z tego samego powodu modele o pełnym pokryciu wykazują długi ogon błędów w polach nieobecnych w dokumencie. W przypadku gemini-3.1-flash 1 286 z 4 287 błędnych komórek to wartości, których w pliku PDF nie było. U modeli zachowawczych (GPT, Claude) takich komórek jest jedynie ok. 470. Pełne pokrycie ma swój koszt: odpowiedź dotycząca pola nieobecnego w dokumencie generuje błąd.
Trafność według pól
wybrane systemy; ciemniejsza komórka oznacza wyższą trafność
| tytuł | autorzy | rok | DOI | czasopismo | wydawca | język | słowa kluczowe | strony | ISSN | abstrakt | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| B0 rejestr | 0.97 | 0.90 | 0.96 | 0.99 | 0.92 | 0.37 | 0.85 | 0.00 | 0.86 | 0.94 | 0.91 |
| gemini-3.1-flash | 0.85 | 0.83 | 0.93 | 0.70 | 0.78 | 0.48 | 0.87 | 0.28 | 0.51 | 0.57 | 0.55 |
| gpt-5.4 | 0.84 | 0.81 | 0.92 | 0.69 | 0.74 | 0.28 | 0.86 | 0.27 | 0.50 | 0.34 | 0.60 |
| B1 GROBID | 0.49 | 0.41 | 0.12 | 0.67 | 0.00 | 0.00 | 0.76 | 0.09 | 0.00 | 0.07 | 0.39 |
| B2 Docling | 0.56 | 0.18 | 0.48 | 0.45 | 0.00 | 0.00 | 0.81 | 0.08 | 0.05 | 0.17 | 0.07 |
<monogr> dla wszystkich 960 dokumentów. Wartość 0.00 dla słów kluczowych w B0 wynika z tego, że Crossref i OpenAlex ich nie przechowują; pola tego nie można zatem ocenić na etapie przesiewowym.5. Trafność według języka publikacji
Z praktycznego punktu widzenia najważniejszy wynik badania przedstawia rys. 7.
Trafność według języka artykułu
średnia 9 modeli LLM a rejestr
Na tej podstawie można by stwierdzić, że modele LLM gorzej radzą sobie z językami azjatyckimi. Przed sformułowaniem takiego wniosku należy jednak przeanalizować pliki PDF, w których modele zawiodły; analiza ta ujawnia kilka nieoczywistych przyczyn błędów.
6. Analiza przypadków: przyczyny błędnych ekstrakcji
6.1. Uszkodzona warstwa tekstowa pliku PDF
Analizowany artykuł z japońskiego czasopisma JunCture dotyczy recepcji Doraemona w Chinach. Ma prosty, przejrzysty skład: jedną kolumnę tekstu z przypisami na marginesie. Dla człowieka i dla modeli wizyjnych nie stanowi trudności, natomiast modele tekstowe zawodzą na nim całkowicie.
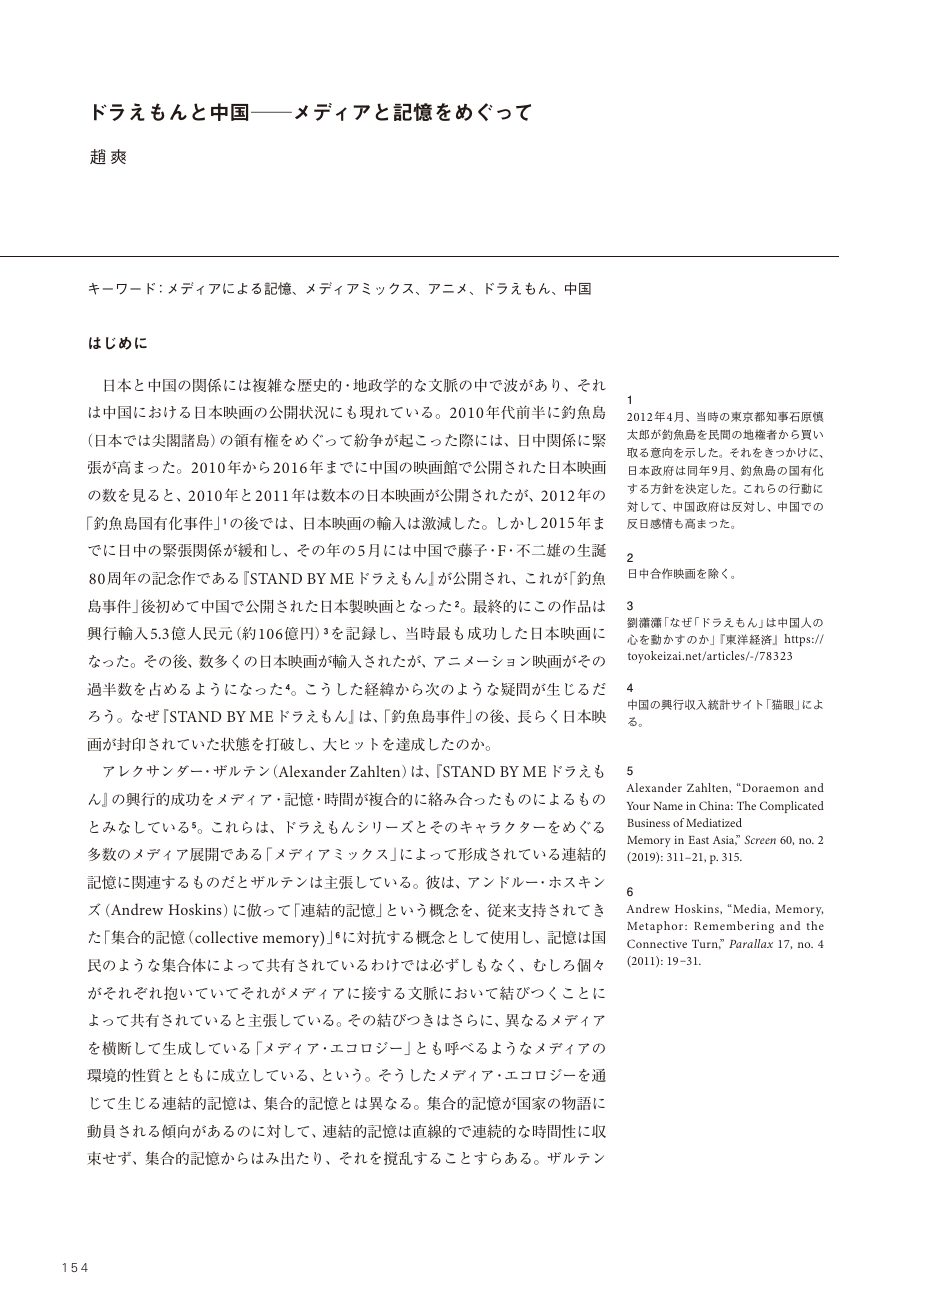 1
2
3
ドラえもんと中国 — strona 1
- Tytuł. Wyraźny, w górnej części strony. Biblioteka
pypdf, użyta do wyodrębnienia tekstu dla modeli tekstowych, w ogóle go nie zwróciła: tekst strony rozpoczyna się od numeru „154”. - Przypis z cytowaniem artykułu w czasopiśmie Screen 60, no. 2 (2019). Modele, które nie otrzymały tytułu, uznały cytowany artykuł za opisywany dokument: czasopismo Screen, rok 2019, DOI cytowanej pracy.
- Jedyną informacją w stopce jest numer strony. Rok publikacji (2024) i DOI nie występują nigdzie w pliku PDF. Najczęściej występującym rokiem w tekście jest 2015, pochodzący z bibliografii.
Ten sam początek strony w wynikach dwóch narzędzi do ekstrakcji tekstu:
pdftotext / pdfminer
ドラえもんと中国─メディアと記憶をめぐって
趙爽
キーワード:メディアによる記憶、…
はじめに
日本と中国の関係には複雑な歴史的・地政学的な
文脈の中で波があり、それは中国における日本映画
の公開状況にも現れている。
pypdf (dane wejściowe modeli tekstowych)
154 ͡Ίʹ 日本ͱ中国ͷ関係ʹ複雑ͳ歴史的ɾ地政学的ͳ文脈ͷ中Ͱ 波͕͋Γɺ ͦΕ中国ʹ͓͚Δ日本映画ͷ公開状況ʹ 現Ε͍ͯΔɻ … ʰSTAND BY ME υϥ͑Μʱ ͕公開͞Εɺ
Znaki kanji zostały zachowane, lecz cała hiragana i katakana zamieniła się w znaki z bloków greckiego, koptyjskiego i IPA. „はじめに” (wstęp) zapisano jako U+0378 U+0361 U+038A U+02B9 (w tym punkt kodowy, któremu Unicode nie przypisał żadnego znaku), a „ドラえもん” jako „υ ϥ ͑ Μ”: greckie ypsilon, literę koptyjską, łączący znak diakrytyczny itd. Przyczyną jest tablica ToUnicode osadzonego fontu, która przypisuje identyfikatorom glifów kany niewłaściwe punkty kodowe. Lepsze narzędzia do ekstrakcji (pdfminer, poppler) obsługują ten przypadek inaczej i zwracają poprawny tekst, natomiast pypdf stosuje mapowanie dosłownie.
| model | wejście | tytuł | rok | czasopismo | DOI |
|---|---|---|---|---|---|
| referencja A / B | ドラえもんと中国 : メディアと記憶をめぐって | 2024 | JunCture / „Institutional Repositories DataBase” | — / 10.18999/juncture.15.154 | |
| gemini-3.1-flash | ドラえもんと中国─メディアと記憶をめぐって | 2023 | JunCture | 10.15083/0002000115 (sfabrykowany; cytat: null) | |
| gpt-5.4 | ドラえもんと中国─メディアと記憶をめぐって | 2016 (z bibliografii) | Juncture | — | |
| claude-sonnet-4.6 | ドラえもんと中国——メディアと記憶をめぐって | — | JunCture | — | |
| deepseek-v3.2 | tekst | 日本Ξχϝͱ中国ͷ関係Λ検討͢Δ | 2019 | Screen | 10.1093/screen/hjz018 |
| qwen-3.5-max | tekst | υϥ͑ΜΛί͙Δ記憶ͱ日中関係 | 2019 | Screen | 10.1093/screen/hjz009 |
W przykładzie tym występuje jednocześnie kilka zjawisk:
- DeepSeek przyjął jako tytuł zdanie z tekstu: „日本アニメと中国の関係を検討する” („zbadać relację między japońską animacją a Chinami”), w zniekształconym zapisie, w jakim je otrzymał.
- Qwen utworzył ze zniekształconych znaków wiarygodnie brzmiący tytuł („pamięć wokół Doraemona i relacje japońsko-chińskie”), którego artykuł nie zawiera.
- Oba modele tekstowe przypisały artykułowi DOI cytowanej pracy oraz czasopismo z przypisu.
- Gemini Flash, mimo poprawnego odczytu strony, wygenerował nieistniejący DOI w formacie japońskiego repozytorium uczelnianego (prefiks 10.15083), z polem „cytat” ustawionym na
null. Jest to typowa halucynacja, możliwa jednak do automatycznego wykrycia, ponieważ model sam sygnalizuje brak dowodu. - Claude podał poprawny tytuł, lecz jako cytat dla pola czasopisma zwrócił „JunCure 15 | 研究論文 | 趣 真”, odczytując nazwisko autora 趙 爽 jako 趣 真. Wartość jest poprawna, dowód błędny.
- Referencja B (OpenAlex) podaje jako „czasopismo” nazwę bazy repozytoriów. Również referencja wzorcowa nie jest zatem wolna od błędów.
6.2. Skala występowania uszkodzonej warstwy tekstowej
Przeanalizowano wszystkie dokumenty CJK, wyznaczając, jaka część znaków spoza ASCII w tekście z pypdf przypada na bloki Unicode, w których tekst japoński nie może występować:
Wynik: 20 z 80 japońskich plików PDF (25%) ma uszkodzoną warstwę tekstową. Są to głównie czasopisma japońskich towarzystw medycznych i inżynierskich, a także kilka czasopism chińskich i koreańskich. W próbie kontrolnej niemieckich i polskich plików PDF pojedyncze wykrycia dotyczą artykułów matematycznych zawierających rzeczywiste litery greckie.
Tytuł i autorzy w japońskich plikach PDF: poprawna a uszkodzona warstwa tekstowa
trafność według modelu; te same 80 artykułów podzielone według μ(d)
ministral-8b (−10 pkt). Jest to analiza post hoc na 20 dokumentach, dlatego jej wynik należy traktować jako silną przesłankę, a nie wynik ostateczny.Wniosek praktyczny: część różnicy na niekorzyść języka japońskiego nie wynika ze słabości modeli w tym języku, lecz z wyboru biblioteki do ekstrakcji tekstu. Potok przetwarzania CRIS przekazujący modelowi tekst powinien najpierw zweryfikować jego poprawność. Wystarcza do tego prosty test \(\mu(d)\); w przypadku wyniku negatywnego należy użyć obrazu strony.
6.3. Wpływ tokenizacji w metryce na ocenę tytułów japońskich
Drugi problem dotyczący języka japońskiego nie leży w plikach PDF ani w modelach, lecz w metryce. Tabela przedstawia przykładowe tytuły, które w ocenie otrzymały wynik 0:
| referencja (OpenAlex / wydawca) | odpowiedź modeli (zgodna z treścią PDF) | różnica |
|---|---|---|
| 重症患者の栄養療法における間接熱量測定 : 普及を目指した新世代間接熱量計の開発 | 重症患者の栄養療法における間接熱量測定:普及を目指した新世代間接熱量計の開発 | dwukropek ASCII ze spacjami a dwukropek pełnej szerokości |
| ドラえもんと中国 : メディアと記憶をめぐって | ドラえもんと中国─メディアと記憶をめぐって | dwukropek a kreska (zgodnie z drukiem) |
| 重症COVID-19肺炎患者の集約化とVV-ECMOによる治療経験 | 重症␣COVID-19␣肺炎患者の集約化と␣VV-ECMO␣による治療経験 | spacje wokół wstawek łacińskich |
Wszystkie trzy odpowiedzi są poprawne. Źródłem problemu jest funkcja \(T(\cdot)\) z definicji metryki, która dzieli tekst według spacji. Hiszpański tytuł z jednym błędem literowym traci jeden token z dwudziestu. Tytuł japoński stanowi jeden „token”, zatem różnica jednego znaku daje indeks Jaccarda równy 0 i brak zawierania. Wystarczy zastosować normalizację uwzględniającą system pisma:
(normalizacja Unicode NFKC, a następnie zachowanie wyłącznie liter i cyfr), aby obraz wyników uległ wyraźnej zmianie:
Trafność tytułu: metryka pierwotna a znormalizowana
8 modeli LLM, wszystkie języki; te same odpowiedzi, inna funkcja porównania
a–z, wskutek czego nazwiska japońskie i chińskie stają się pustymi ciągami znaków i zawsze są uznawane za zgodne. Po korekcie trafność w polu autorów dla języka japońskiego spada z 0.80 do 0.70.Wniosek metodologiczny
Metryka zaprojektowana z myślą o językach europejskich zaniża wynik w jednym polu i zawyża go w drugim, i to właśnie dla języków będących przedmiotem badania. Różnica ta przewyższa odstęp między najlepszym a najsłabszym modelem z czołówki. Porównania międzyjęzykowe bez normalizacji uwzględniającej system pisma mierzą w znacznej mierze właściwości tokenizera metryki.
6.4. Niejednoznaczność roku publikacji
Kolejny przypadek dotyczy czasopisma polskiego. W artykule z Bromatologii i Chemii Toksykologicznej, poświęconym polifenolom w piwach bezalkoholowych, wszystkie osiem modeli zgodnie wskazało rok publikacji 2021. Wszystkie otrzymały za tę odpowiedź zero, ponieważ OpenAlex podaje rok 2023.
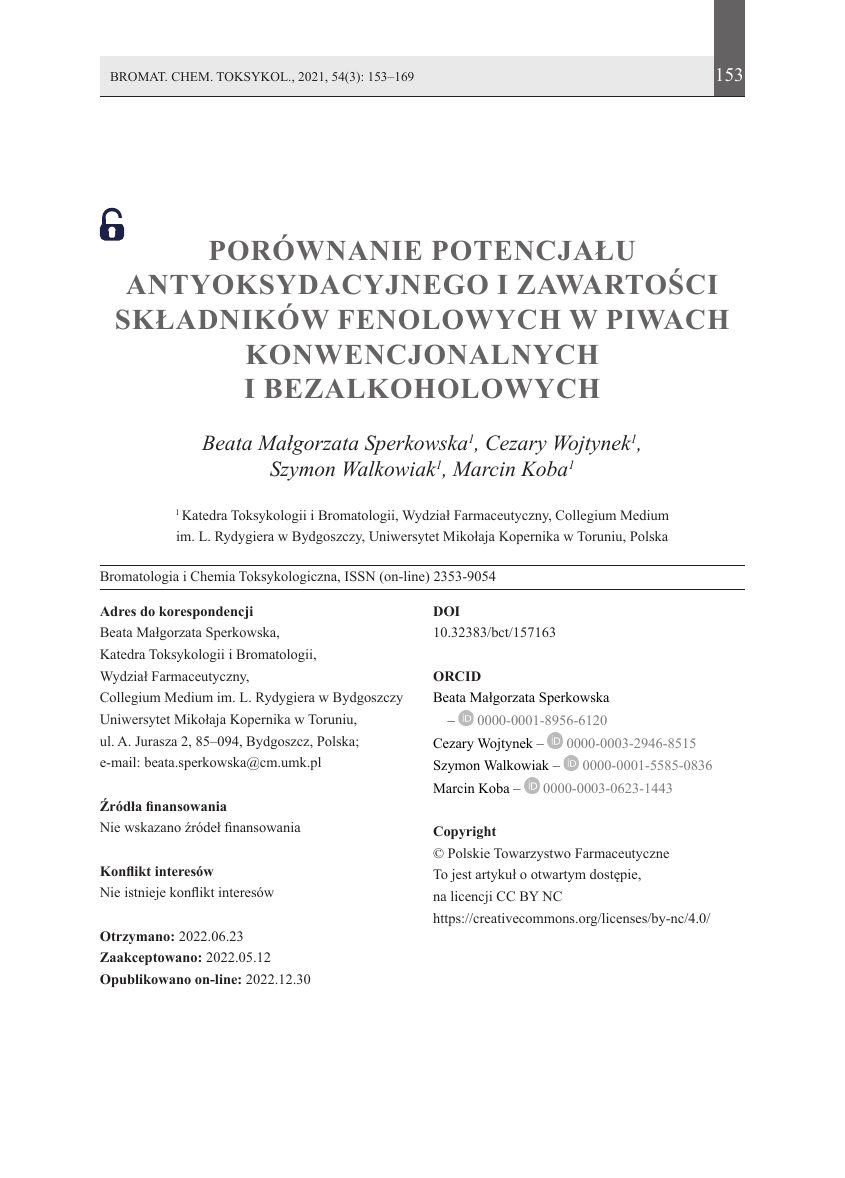 1
2
3
4
Bromat. Chem. Toksykol. 54(3) — strona 1
- Nagłówek: „2021, 54(3)”. Formalnie jest to rok tomu. Tę wartość wybrały wszystkie modele, a GPT, Ministral i Qwen przytoczyły ją dosłownie jako cytat.
- ISSN umieszczony w wąskim pasku między liniami, nad blokiem metadanych. Wydrukowano wyłącznie ISSN wersji elektronicznej.
- DOI bez prefiksu „doi.org” i bez etykiety, w prawej kolumnie pod nagłówkiem „DOI”, obok adresu do korespondencji.
- „Otrzymano: 2022.06.23, Zaakceptowano: 2022.05.12”. Według tych danych artykuł przyjęto sześć tygodni przed jego wpłynięciem. Publikacja on-line nastąpiła 30.12.2022. Jedyny model, który uwzględnił ten blok (Claude), wskazał rok 2022.
Daty związane z jednym artykułem a „rok publikacji”
wszystkie daty dotyczące jednego artykułu
Nie jest to przypadek odosobniony. Polskie czasopisma nadrabiające opóźnienia wydawnicze regularnie wydają w roku N+1 lub N+2 tom datowany na rok N. Teka Komisji Urbanistyki i Architektury PAN ma w nagłówku „TOM XLIX/2021”, a OpenAlex podaje rok 2023. Nowa Audiofonologia drukuje „2024; 13(4)” i „Opublikowano: 30.12.2024”, a rejestr podaje rok 2025. W każdym z tych przypadków wszystkie modele są ze sobą zgodne, poprawne względem pliku PDF i błędne względem rejestru. Dla systemu CRIS i ewaluacji parametrycznej, w których rok decyduje o przypisaniu publikacji do okresu sprawozdawczego, rozbieżność ta ma istotne znaczenie.
6.5. Wybór tytułu w publikacjach dwujęzycznych
Drugim problemem dotyczącym czasopism polskich jest dwujęzyczność, co ilustrują dwa poniższe artykuły.
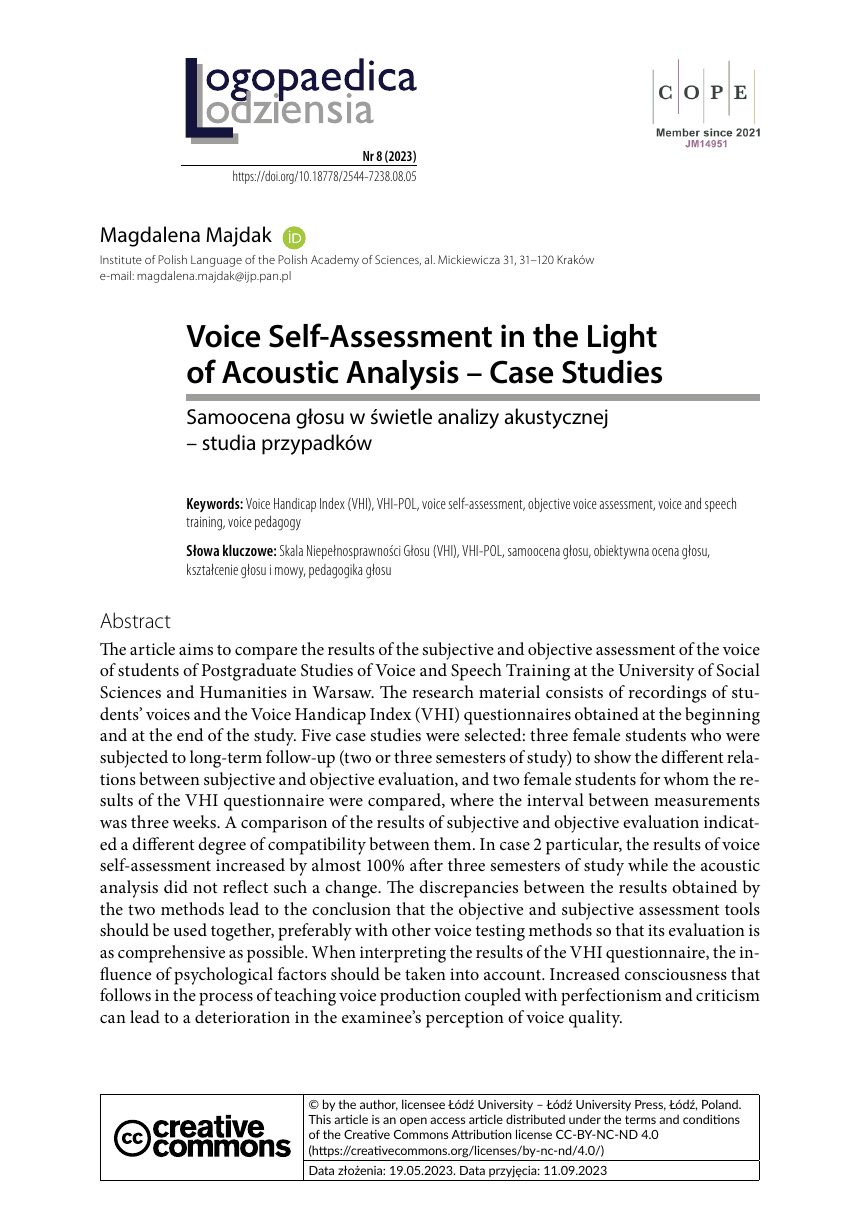 1
2
3
4
Logopaedica Lodziensia nr 8 (2023)
- „Nr 8 (2023)”: rok w nawiasie przy numerze, zapisany małą czcionką.
- Tytuł angielski, duży i pogrubiony, wyeksponowany jako główny. Wybrały go wszystkie modele.
- Tytuł polski, mniejszy, w formie podtytułu. Ten tytuł figuruje w rejestrze i na stronie wydawcy. Wynik: zero dla wszystkich modeli.
- Daty złożenia i przyjęcia w stopce z informacją o licencji, u dołu strony.
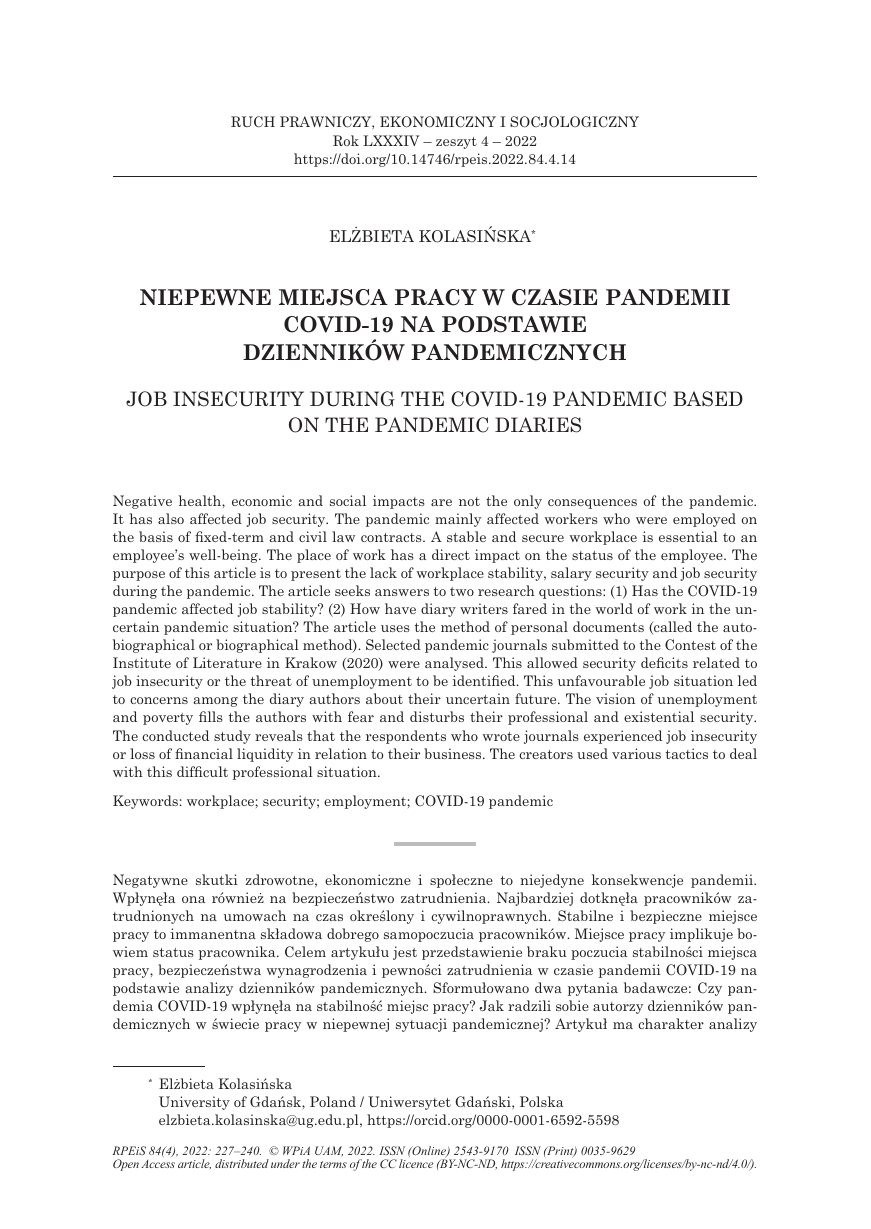 1
2
3
4
Ruch Prawniczy, Ekonomiczny i Socjologiczny 84(4)
- Rok, zeszyt i DOI w nagłówku, umieszczone centralnie i czytelnie. W tym zakresie modele nie popełniły błędów.
- Tytuł wydrukowany: „NIEPEWNE MIEJSCA PRACY…”. W rejestrze i na stronie wydawcy figuruje „Niepewność miejsca pracy…”. Tytuł w rejestrze różni się od tytułu w artykule.
- Tytuł angielski „Job insecurity…”, odpowiadający raczej wersji z rejestru.
- ISSN wersji elektronicznej i drukowanej w stopce złożonej bardzo małym stopniem pisma u dołu strony, wraz z informacją o prawach autorskich i licencji. Jest to przykład nietypowego umiejscowienia metadanych.
W pierwszym przypadku modele wybierają tytuł wyeksponowany graficznie, a rejestr zawiera tytuł w języku publikacji. W drugim modele wiernie przepisują treść strony, a referencja różni się od druku jednym słowem. Występuje również sytuacja odwrotna: w Psychiatrii Polskiej PDF zawiera polski tytuł „Stres wojny…”, a rejestr angielski „The stress of war…”. Dla systemu CRIS poprawną odpowiedzią są oba tytuły z oznaczeniem języka, czego schemat z jednym polem title nie przewiduje.
Wspólna przyczyna
W żadnym z czterech opisanych przypadków model nie halucynuje w ścisłym sensie. Zawodzą elementy otaczające model: biblioteka do ekstrakcji tekstu, metryka, referencja lub schemat zakładający jeden tytuł i jeden rok. Na etapie przesiewowym ok. 26–34% komórek każdego modelu przypada na kategorię „niezgodne z referencją”; bez ręcznej anotacji nie można jeszcze określić, ile z nich stanowią przypadki tego rodzaju.
7. Taksonomia błędów
Taksonomia wyników na poziomie komórek
odsetek komórek (dokument × pole) w każdej klasie
Z analizy wynikają trzy obserwacje:
- Problem zgodności ze schematem został rozwiązany. Struktura odpowiedzi nie jest już czynnikiem ograniczającym. JSON jest poprawny w 99,5% przypadków, a pozostałe przypadki to głównie puste odpowiedzi API i nieuporządkowane wyniki najmniejszego modelu.
- Błąd proweniencji (1–4%) jest istotniejszy niż halucynacja: wartość jest poprawna, lecz cytat wskazujący jej źródło jest błędny lub go brak (jak „趣 真” w odpowiedzi modelu Claude). Jeżeli dalsze etapy przetwarzania opierają się na polu
evidence_span, błąd ten jest poważniejszy, niż się wydaje. - Błędy normalizacji (4–8% w modelach Gemini, ok. 0% w modelach Claude i GPT) to wartości semantycznie poprawne, lecz niezgodne z postacią kanoniczną: wielkość liter w DOI, brak dywizu w ISSN, rok zakończony kropką.
8. Implikacje dla systemów CRIS
- Rejestr przed modelem. Przeznaczanie 250 USD na tokeny w celu uzyskania wyniku gorszego niż z bezpłatnego API jest niewłaściwym wyborem domyślnym.
- Tani model jest wystarczający. W zadaniu ograniczonym schematem użycie najdroższych modeli nie jest uzasadnione.
- Weryfikacja tekstu przed przekazaniem go modelowi. Prosty test wykrywający zniekształcone znaki zapobiega utracie 80% trafności w co czwartym japońskim pliku PDF. Alternatywą jest bezpośrednie przekazywanie modelowi obrazu strony.
- Możliwość odmowy odpowiedzi jest zaletą. Model pozostawiający puste pole ISSN, gdy wartość ta nie występuje w dokumencie, daje lepsze wyniki niż model, który zawsze wpisuje jakąś wartość.
- Schemat CRIS powinien uwzględniać wielojęzyczność i wiele dat. Pojedyncze pola
titleiyearnie odzwierciedlają praktyki polskich i japońskich czasopism. - Metryki międzyjęzykowe wymagają normalizacji uwzględniającej system pisma. W przeciwnym razie porównaniu podlegają tokenizery, a nie modele.
9. Ograniczenia i dalsze prace
Przedstawione wyniki pochodzą z etapu przesiewowego. Referencje A i B są źródłami operacyjnymi, a nie prawdą absolutną; przypadki z Bromatologii i RPEiS pokazują, że również one zawierają błędy. Ostateczne wartości (rzeczywistą trafność, rzeczywisty odsetek halucynacji oraz podział 26–34% „niezgodności” na błędy modelu i błędy referencji) przyniesie dopiero złoty zbiór 96 artykułów, anotowany ręcznie przez dwie osoby z rozstrzyganiem rozbieżności. Zbiór został wyselekcjonowany według reguły zarejestrowanej przed analizą wyników i oczekuje na anotację.
Analiza uszkodzonej warstwy tekstowej (rys. 8) i ponowne obliczenie trafności tytułów po normalizacji (rys. 9) są analizami post hoc, przeprowadzonymi po zapoznaniu się z wynikami. Nie były uwzględnione w planie zarejestrowanym przed badaniem i należy je interpretować z tym zastrzeżeniem.
Całe badanie przesiewowe (9 modeli × 960 dokumentów) kosztowało ok. 252 USD w opłatach za API. Wszystkie analizy przedstawione w niniejszym wpisie są wyłącznie przetworzeniem istniejących wyników i nie wygenerowały dodatkowych kosztów (0 USD).
Metodologia w skrócie. Korpus: 960 artykułów OA z OpenAlex, stratyfikacja 4 lata × 12 języków × 4 dziedziny × 5, losowanie z ustalonym ziarnem. Schemat: 11 pól z proweniencją (typ źródła, cytat, pewność, normalizacja). Prompt: jeden kanoniczny (V1), temperatura 0. Wejście: dynamiczne przycięcie stron dla każdego dokumentu. Modele wizyjne otrzymują PDF, modele tekstowe tekst wyodrębniony przez pypdf. GROBID 0.9.0 uruchomiony lokalnie (endpoint nagłówkowy, bez konsolidacji z Crossref), Docling 2.93. Ocena: max(A, B) z warunkiem dostępności; wyniki A i B raportowane osobno. Wyniki są odporne na wykluczenie rekordów z zastrzeżeniami (Δ ≤ 0.004).
Wyniki zostaną zaprezentowane na konferencji EuroCRIS 2026.