1. Cel badania i materiał testowy
W poprzedniej części serii opisaliśmy odczyt 672 stron akt Konstantego Kruszyńskiego wykonany modelem Gemini 3.8 Flash kosztem 12 dolarów. Nierozstrzygnięta pozostała kwestia dokładności tego odczytu. Własny zbiór referencyjny (18 stron z zespołu) oczekuje na korektę. Otwarty zbiór polskich rękopisów z transkrypcjami, przeznaczony do oceny automatycznego rozpoznawania pisma, nie istnieje: dostępne zbiory testowe obejmują z języka polskiego wyłącznie druki, a katalog HTR-United nie zawiera materiału polskiego.
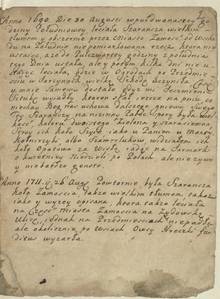
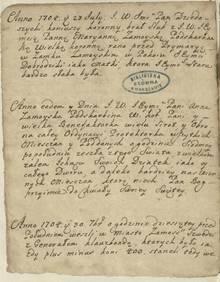
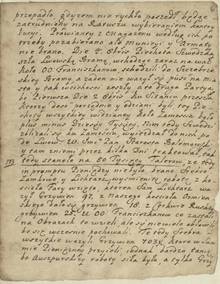
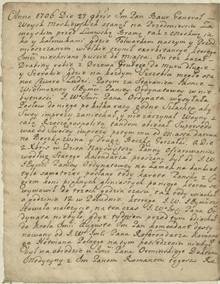
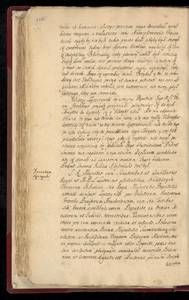
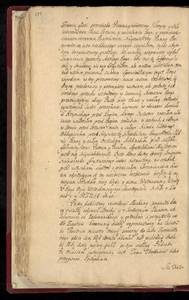
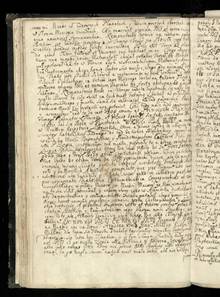
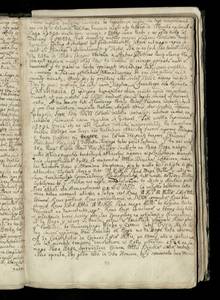
Zestawiliśmy zatem niewielki zbiór testowy z materiałów dostępnych w sieci. Dla każdej strony istnieje transkrypcja wykonana przez człowieka:
| Źródło | Zawartość | Stron w teście | Transkrypcja |
|---|---|---|---|
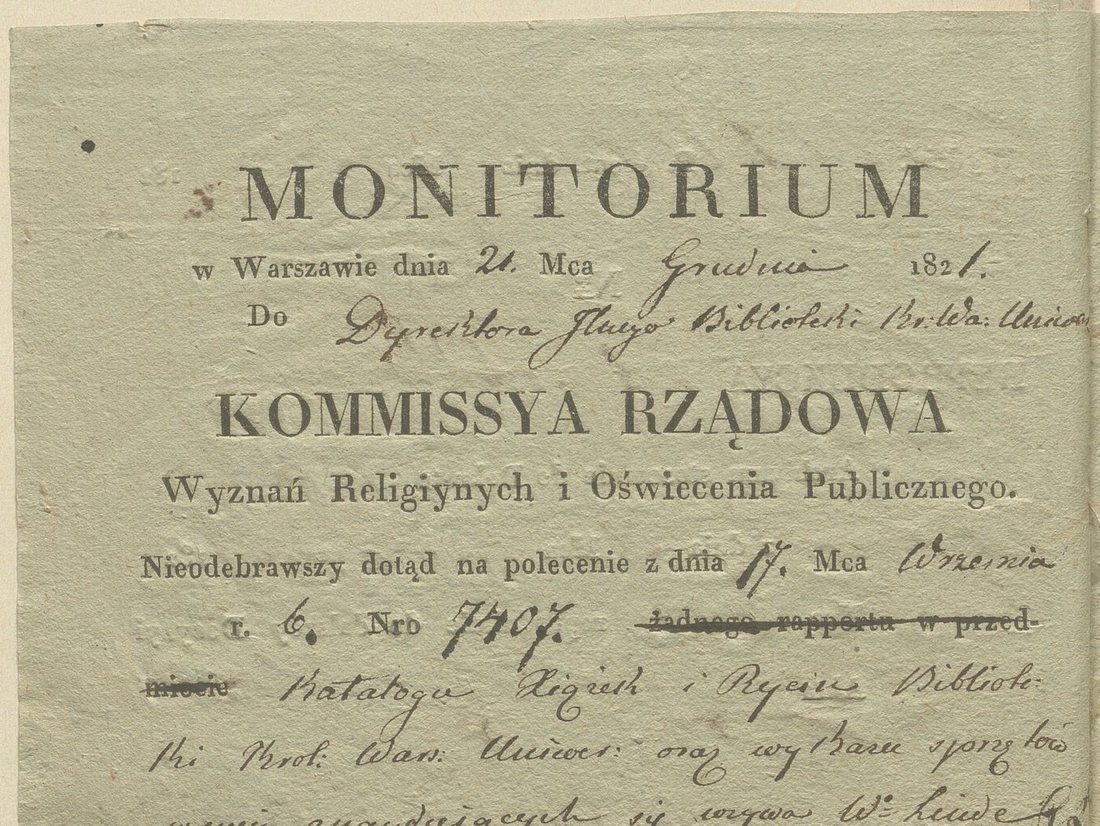
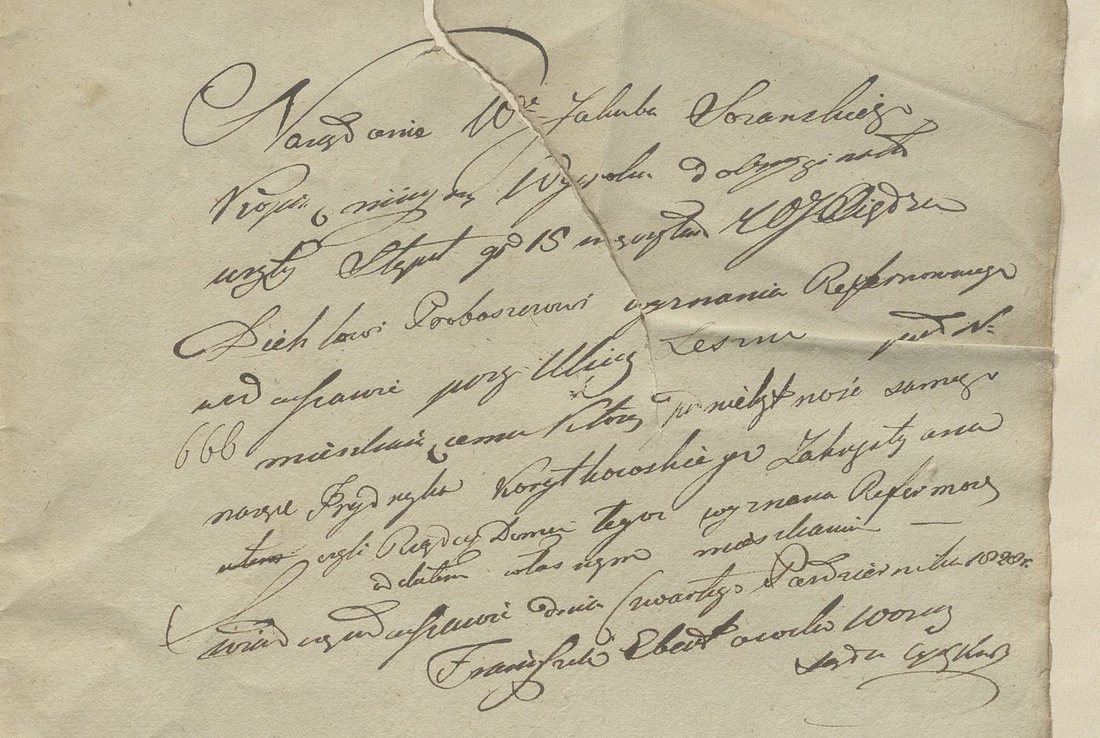
| TranskriBUW (BUW) | „Connotacya” mieszczanina zamojskiego 1689–1726; akta rozwodowe 1792–1828; akta Komisji Rządowej Wyznań Religijnych i Oświecenia Publicznego (KRWRiOP) 1821 | 16 | wykonana przez wolontariuszy i zatwierdzona przez redakcję BUW; dyplomatyczna, bez rozwijania skrótów |
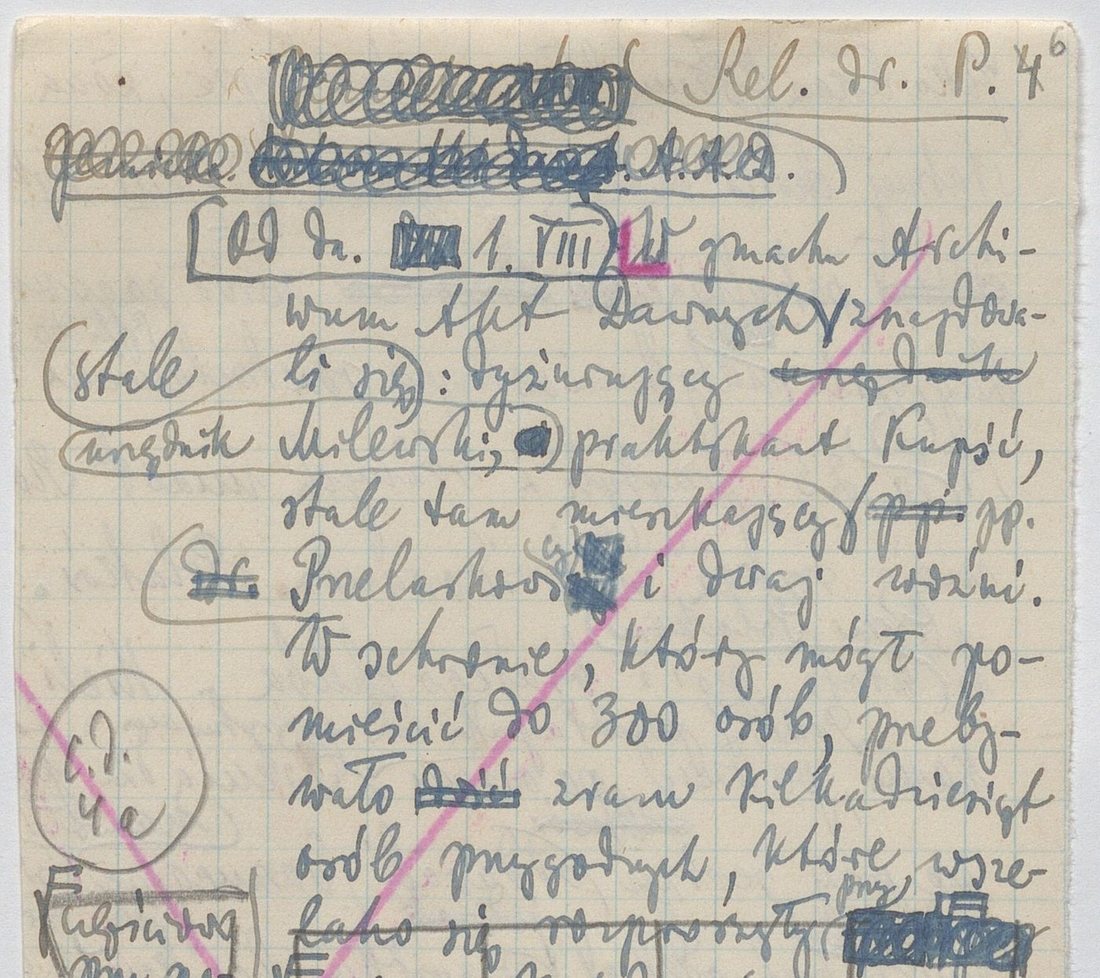
| TranskriBUW | relacje z Powstania Warszawskiego 1944, ołówek, skreślenia kredką (materiał kontrolny) | 2 | jw. |
| Wikiźródła | „Sekreta różne”, receptariusz z 1752 r. (AGAD) | 4 | uwierzytelniona |
| Wikiźródła | sprawa Łyszczyńskiego 1689 (kopie z XVII–XVIII w.), list z Archiwum Radziwiłłów | 8 | częściowo nieskorygowana |
Pobraliśmy również 42 strony niemieckiej kurrenty z diariusza dworu drezdeńskiego (Zenodo). Materiał ten jest istotny, ponieważ w aktach Kruszyńskiego kurrentą zapisano 185 stron. Niniejszy test dotyczy jednak wyłącznie tekstów polskich.
2. Metoda pomiaru
- 1 · pobranieSkany i transkrypcjeOmeka S i MediaWiki BUW, API Wikiźródeł, Commons. 296 stron, z nich 30 polskich do testu.
- 2 · czyszczenieTekst referencyjnyUsunięcie znaczników edytorskich, szablonów wiki, przypisów wydawcy i homoglifów (cyrylickie „а”, „о”).
- 3 · odczytPolecenie zgodne z przetwarzaniem produkcyjnymInstrukcja z naszego potoku przetwarzania: transkrypcja dyplomatyczna, [?] przy niepewnych słowach, schemat JSON.
- 4 · 7 wariantówGemini, Sol, SonnetKażdy wariant odczytuje każdą stronę jednokrotnie, bez poprawek i bez ponowień.
- 5 · wynikCER stronyOdsetek znaków wymagających poprawy: ścisły (znak po znaku) i znormalizowany (bez uwzględnienia wielkości liter i interpunkcji).
CER (character error rate) to liczba wstawień, usunięć i zamian znaków potrzebnych do przekształcenia odczytu modelu w tekst referencyjny, podzielona przez długość tekstu referencyjnego. Wartość 5% odpowiada w przybliżeniu jednemu błędnemu słowu w wierszu; przy 20% tekst wymaga ponownego przepisania z oryginału. Porównujemy całe strony bez podziału na wiersze, ponieważ Wikiźródła łączą wiersze w akapity.
2.1. Badane warianty modeli
| Wariant | Model | Ustawienie | Cena za 1M tok. (wej./wyj.) |
|---|---|---|---|
| gemini-low | Gemini 3.8 Flash, AI Studio | rozumowanie low, obraz w najwyższej rozdzielczości | $0,75 / $3,75 |
| gemini-high | Gemini 3.8 Flash, AI Studio | rozumowanie high | $0,75 / $3,75 |
| gemini-low-or, -high-or | Gemini 3.8 Flash przez OpenRouter, tylko Vertex | low / high, domyślna rozdzielczość | $0,75 / $3,75 |
| sol-low, sol-high | GPT-6.1 Sol (OpenAI) | reasoning low / high, obraz w oryginalnej rozdzielczości | $2 / $10 |
| sonnet-high | Claude Sonnet 5.5 (Anthropic) | adaptive thinking, effort high | $2 / $10 |
3. Dokładność odczytu
Główny wynik badania: Gemini 3.8 Flash odczytuje polskie rękopisy najdokładniej i najtaniej. Wariant low, stosowany w przetwarzaniu produkcyjnym, kosztuje poniżej jednego centa za stronę, a jego odsetek błędów jest niemal równy odsetkowi błędów wariantu high, dziesięciokrotnie droższego. Drugie miejsce zajmuje Sonnet 5.5. Oba warianty Sola osiągają najsłabsze wyniki, a Sol high jest ponadto najdroższy.
Koszt strony a odsetek błędów
Oś pozioma logarytmiczna, cena standardowa (bez rabatów). CER ścisły ważony liczbą znaków; uwzględniono wyłącznie strony odczytane przez wszystkie pokazane warianty, z wyłączeniem relacji z 1944 r.
Kolejność wariantów zależy w pewnym stopniu od doboru stron. Na 21 stronach odczytanych przez wszystkie siedem wariantów (przełącznik powyżej) wynik Sonneta zbliża się do wyniku Gemini low (10,9% wobec 10,3%). Z porównania są wówczas wyłączone strony najtrudniejsze, na których Sonnet traci najwięcej, a Gemini najczęściej przerywa odczyt. Zagadnienie to omówiono w sekcji 7.
Odsetek błędów według dokumentu
CER ścisły w grupie stron. W nawiasie: strony odczytane przez wszystkie 5 wariantów / strony w grupie.
Z wykresu wynikają trzy obserwacje:
- Przy czytelnym piśmie wyniki są wyrównane. „Connotacya” z Zamościa jest zapisana starannie i każdy model osiąga 4–5% błędów, wynikających przeważnie z różnic konwencji (wielka litera, „y” zamiast „i”).
- Różnice ujawniają się przy piśmie trudnym. W aktach rozwodowych z lat 1822–23 odsetek błędów wynosi 12–13% dla Gemini, 17% dla Sonneta i 19–23% dla Sola.
- Wyższy koszt wariantu high Gemini jest uzasadniony jedynie w przypadku formularzy. Na drukowanych formularzach KRWRiOP wypełnionych ręcznie wariant low osiąga 18%, a high 10%. W pozostałych grupach różnica mieści się w granicach błędu pomiaru.
4. Wyniki dla poszczególnych stron
Wiersze mapy odpowiadają stronom, kolumny wariantom. Ciemniejsze pole oznacza wyższy odsetek błędów, a pole kreskowane odczyt przerwany przez Gemini. Szczegóły wyświetlają się po wskazaniu pola kursorem.
5. Analiza wybranych stron
Poniżej omówiono pięć stron, na których różnice między modelami są szczególnie wyraźne.
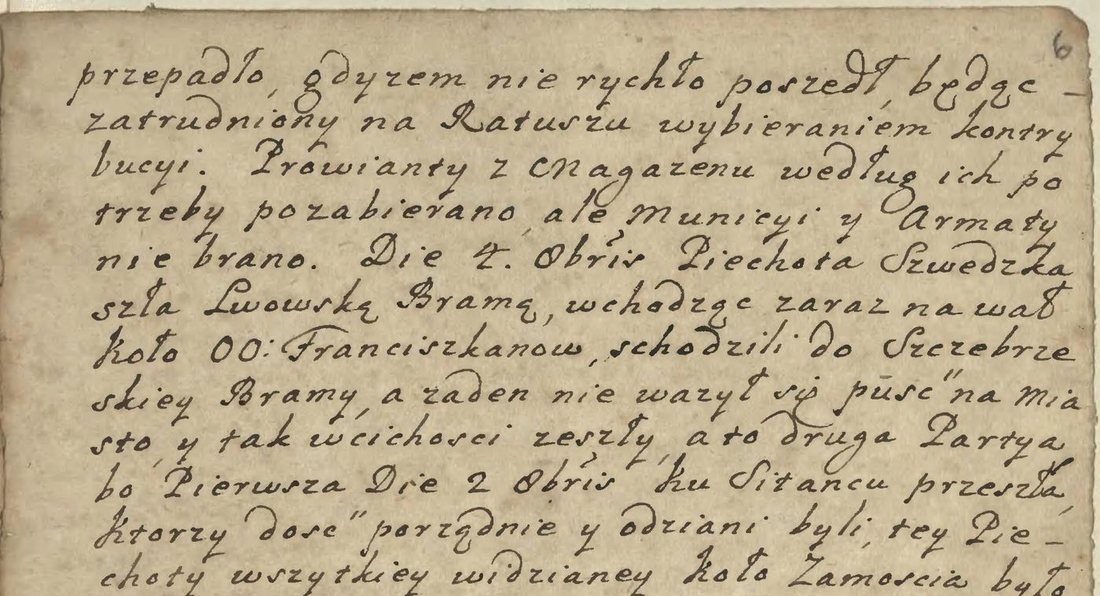
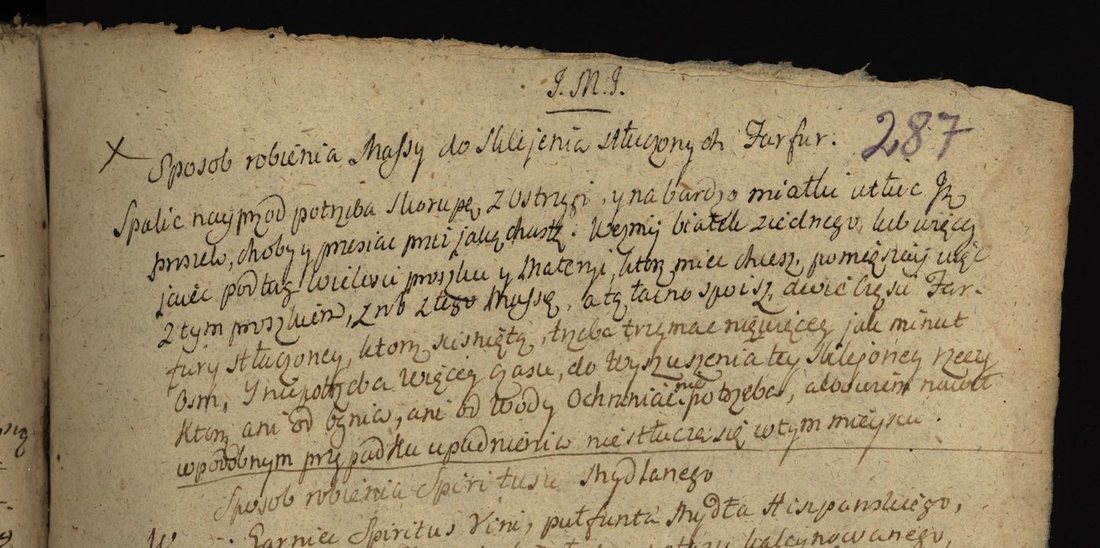
5.1. Porównanie czterech odczytów jednego fragmentu
„Sekreta różne”, s. 9: przepis zapobiegający bliznom po ospie. Podkreślenie falowane oznacza błąd, a kropkowane różnicę wyłącznie w wielkości liter, znakach diakrytycznych lub interpunkcji. W indeksie górnym podano tekst referencyjny.
Znaczna część oznaczeń to różnice konwencji. Modele uwspółcześniają „Swiezego” do „świeżego” i dodają nagłówek „J. M. J.”, pominięty w transkrypcji Wikiźródeł. CER ścisły traktuje te różnice jako błędy, CER znormalizowany ich nie uwzględnia. Z tego powodu w tabelach podajemy obie miary.
6. Koszt i efekt rozumowania
Modele z funkcją rozumowania zużywają tokeny na ukryte rozumowanie przed wygenerowaniem odpowiedzi; tokeny te są rozliczane jak odpowiedź. W zadaniu transkrypcji rękopisu dodatkowy koszt prawie nie przekłada się na dokładność.
Struktura tokenów na stronę
Średnio na stronę, wszystkie 30 stron. Wejście (obraz + polecenie), rozumowanie, widoczna odpowiedź.
Rozumowanie a poprawa dokładności
Punkty odpowiadają stronom. Oś pozioma: tokeny rozumowania Gemini high. Oś pionowa: różnica CER między wariantami low i high w punktach procentowych.
- W kalibracji (3 strony) Gemini high zużywał średnio 7,7 tys. tokenów rozumowania na stronę, w pełnym teście 23,8 tys., a maksymalnie 87 915 tokenów dla jednej strony „Sekretów”. Odpowiada to około 30 stronom tekstu; CER tej strony spadł z 9,0% do 8,0%.
- Sol high zużywa podobną liczbę tokenów rozumowania (12 tys.), lecz cena tokenu jest prawie trzykrotnie wyższa. Ponadto obraz w pełnej rozdzielczości to w jego przypadku 7,4 tys. tokenów wejściowych, wobec 3,1 tys. u Gemini.
- Sonnet 5.5 zużywa niewiele tokenów rozumowania (2,1 tys.), a generuje najdłuższe odpowiedzi, ponieważ szczegółowiej opisuje marginesy, kolor atramentu i rękę.
7. Przerwane odczyty w modelu Gemini
Najistotniejszy wynik badania nie dotyczy odsetka błędów. Na części stron Gemini przerywa odpowiedź w trakcie generowania, często w połowie zdania. Blokady odnotowaliśmy już wcześniej w rdzeniu zespołu (2,8% stron przetworzono w trybie awaryjnym); w niniejszym teście okazały się one zależne od dokumentu, a nie przypadkowe.
7.1. Miejsce przerwania odpowiedzi
Za pośrednictwem OpenRouter dostępny jest tekst wygenerowany przed przerwaniem (bezpośrednie API Google zwraca w takim przypadku pustą odpowiedź). Długość paska odpowiada całej stronie (2 285 znaków tekstu referencyjnego), a wypełnienie części wygenerowanej.
7.2. Próby kontrolne
| Polecenie dla Gemini (s. 5, rozumowanie low) | AI Studio | Vertex |
|---|---|---|
| Streszczenie treści rękopisu w języku angielskim | pełna odpowiedź | pełna odpowiedź |
| Transkrypcja dyplomatyczna z obrazu (sam tekst, bez JSON) | przerwane | przerwane |
| Transkrypcja z obrazu z uwspółcześnioną pisownią | przerwane (51 zn.) | przerwane (25 zn.) |
| Bez obrazu: powtórzenie bez zmian wklejonego tekstu całej strony | pełna odpowiedź | pełna odpowiedź |
| Bez obrazu: przekład tego tekstu na angielski | pełna odpowiedź | pełna odpowiedź |
| Obraz w skali szarości, obrócony o 2°; obraz pomniejszony do 60% | przerwane | przerwane |
| Wyłącznie dolna połowa strony (bez tytułu „Sposób robienia…”) | pełna odpowiedź | przerwane (704 zn.) |
7.3. Hipotezy dotyczące przyczyny przerwań
| Hipoteza | Ocena | Uzasadnienie |
|---|---|---|
| Filtr recytacji: model nie odtwarza tekstu z danych treningowych (Wikiźródła są dostępne w sieci) | mało prawdopodobna | Wklejony tekst model powtarza w całości. Wersja uwspółcześniona, nieobecna w sieci, również jest przerywana. |
| Rozpoznanie konkretnego skanu z Commons | odrzucona | Zmodyfikowane obrazy (skala szarości, obrót, pomniejszenie) również są przerywane. |
| Klasyfikator wyjścia dla zadań „obraz → tekst”, czuły na instrukcje typu „jak zrobić” (palenie, proszki, masy) | najbardziej prawdopodobna | Przerwanie następuje tuż po „Sposób robienia…”, streszczenie nie jest blokowane, a dolna połowa strony bez nagłówka została odczytana w AI Studio. Hipoteza nie wyjaśnia, dlaczego tekst bez obrazu nie jest blokowany. |
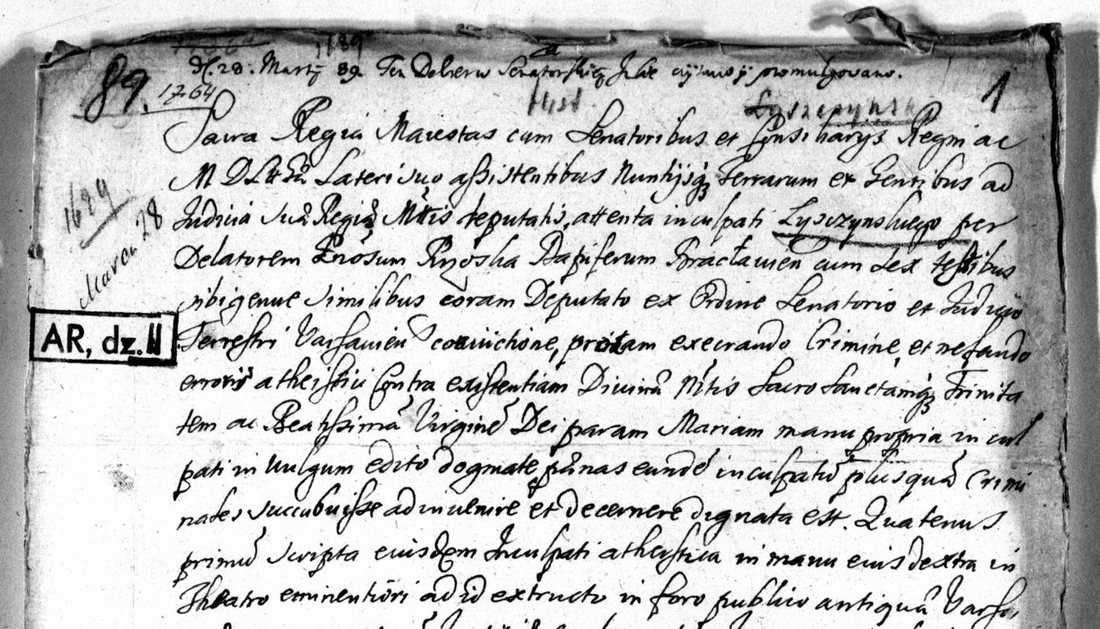
| Klasyfikator treści religijnych i przemocy (tylko Vertex) | możliwa | Vertex przerwał również odczyt obu kopii akt sprawy Łyszczyńskiego (ateizm, bluźnierstwo, egzekucja w 1689 r.) przed pierwszym znakiem. AI Studio odczytało te strony. |
Wnioski praktyczne:
- Ten sam model udostępniany przez dwie usługi podlega różnym filtrom. AI Studio (wykorzystywane w projekcie) zablokowało 3 z 60 odczytów, Vertex za pośrednictwem OpenRouter 10 z 60.
- Blokady zależą od rodzaju dokumentu, a nie od jakości skanu. Receptariusze, poradniki i akta spraw o bluźnierstwo mogą zostać pominięte w całości. Przepisy gospodarskie mogą występować również w papierach majątkowych Nawry.
- Ponowienie zapytania nie rozwiązuje problemu. Rozwiązaniem jest użycie innego modelu: Sol i Sonnet nie zablokowały żadnej strony. Na odczytanych stronach „Sekretów” Gemini osiąga 9% CER, a Sonnet 15%; model zastępczy zapewnia tekst kosztem niższej dokładności.
8. Wiarygodność samooceny modeli
Każdy odczyt zawiera samoocenę czytelności strony (dobra, średnia, słaba) oraz znaczniki [?] przy niepewnych słowach. Jeżeli sygnały te są zgodne z rzeczywistym CER, mogą służyć do kierowania do drugiego odczytu lub korekty wyłącznie tych stron, dla których model sam sygnalizuje niepewność.
Samoocena czytelności a rzeczywisty odsetek błędów
Średni CER stron, które model ocenił jako dobrze, średnio lub słabo czytelne; liczba stron pod słupkiem.
Samoocena Sonneta jest najlepiej skalibrowana. Jego trzy oceny wyznaczają grupy stron o CER 4,7%, 16% i 26%. Znaczniki [?] umieszcza na 25 z 30 stron, a strony bez znaczników odczytuje niemal bezbłędnie (4,8%). Ocena Gemini high rozróżnia dwa poziomy (8% wobec 20%), a Gemini low umieścił znaczniki [?] tylko na 6 stronach, przy czym również tam, gdzie popełniał błędy. Ma to znaczenie dla korekty: odczyt Gemini jest dokładniejszy, lecz trudniej wskazać w nim miejsca wymagające sprawdzenia.
Najlepszy odczyt każdej strony
CER ścisły na 28 stronach odczytanych przez wszystkie 5 głównych wariantów. Ostatni słupek to górna granica łączenia modeli, osiągalna wyłącznie przy trafnym wyborze odczytu.
Wybór najlepszego z pięciu odczytów dla każdej strony obniżyłby błąd z 10,8% (Gemini high) do 9,5%. Odczyt każdej strony przez kilka modeli przynosi zatem niewielką korzyść w porównaniu z samym Gemini. Użycie drugiego modelu jest uzasadnione tam, gdzie pierwszy nie zwrócił tekstu.
9. Tryby przetwarzania Flex i Batch
Ze względu na najwyższy koszt Sola próbowaliśmy wykorzystać tańsze tryby OpenAI, oba z rabatem 50%: Flex (zapytania obsługiwane przy dostępnej mocy obliczeniowej) i Batch (przetwarzanie wsadowe w ciągu 24 godzin). Przebieg prób:
- 12.10, kalibracjaTryb Flex działa przy zapytaniu próbnym (5 tokenów).
- 12.10, przebieg38 z 54 zapytań zostaje odrzuconych z kodem
flex_unavailable(„Flex processing is temporarily unavailable”). Obsłużone zapytania trwały do 21 minut na stronę. - 12.10, BatchZgłoszenie zadania odrzucone z komunikatem „Billing hard limit has been reached” (limit wydatków konta, niezależny od limitu w skrypcie). Konto zostało doładowane.
- 13.10, 9:59Wysłanie zadania wsadowego z 38 odczytami.
- 11:25 → 12:18 → 13:21Postęp: 1 z 38, następnie 17 z 38, po godzinie bez zmian. Tryb Batch nie udostępnia wyników częściowych przed zakończeniem zadania.
- 13:25Anulowanie zadania. OpenAI zwraca 17 gotowych odczytów w cenie wsadowej; pozostałe 21 wykonano w trybie standardowym w czasie poniżej godziny.
- „Mlijenia sztucznych Furfur”Odczyt Sonneta dla nagłówka „Sklejenia stłuczonych Farfur”, czyli przepisu na klej do porcelany.
- „nachalność”Odczyt Gemini low w miejscu „na sameo Pana boga” w mowie Zabistowskiego. Gemini high odczytał „Maiestat”, co pozostaje zgodne z sensem zdania.
- Anno 1609Tekst referencyjny „Connotacyi” podaje rok 1609 w miejscu, w którym skan i źródła historyczne wskazują rok 1689. Transkrypcje referencyjne również zawierają błędy.
- „0.5em 2em 200%”Błąd we własnym potoku przetwarzania: przy czyszczeniu szablonów wiki pobierane były parametry stylu zamiast tekstu. Po poprawce CER niektórych dokumentów z Wikiźródeł spadł o kilkanaście punktów procentowych.
- brak przecinkaGemini za pośrednictwem OpenRouter czterokrotnie zwrócił JSON bez przecinka między obiektami. Ponowne zapytanie zwracało poprawny wynik.
- 300 sekundLimit czasu odpowiedzi Gemini. Został przekroczony jeden raz; ponowiony odczyt tej strony akt rozwodowych trwał 204 s i zużył 22,8 tys. tokenów rozumowania.
10. Szacunkowy koszt odczytu całego zespołu
Archiwum Sczanieckich liczy 60 197 skanów. Przyjmujemy, że tekst zawiera ok. 69% z nich, tak jak w rdzeniu (672 z 973), czyli ok. 41 500 stron. Wykres przedstawia koszt jednokrotnego odczytu każdym wariantem w cenie standardowej i w trybie wsadowym (rabat 50% u wszystkich trzech dostawców).
Jednokrotny odczyt całego zespołu
USD, koszt na stronę zmierzony w teście × 41 500 stron. Słupek jasny: cena standardowa, ciemny: tryb wsadowy.
Rozpiętość kosztów przekracza trzydziestokrotność: od ok. 200 dolarów (Gemini low, tryb wsadowy) do ok. 7 200 dolarów (Sol high, cena standardowa). Pełny potok przetwarzania (dwa odczyty, graf wiedzy, rozstrzyganie nazw) kosztował w rdzeniu $0,018 za stronę w trybie wsadowym, co dla całego zespołu daje ok. 740 dolarów. Cennik wsadowy Gemini zmienia się w 2027 roku i przed przetwarzaniem na dużą skalę wymaga ponownego przeliczenia.
11. Rekomendowany przepływ pracy
Z wyników testu wynika następująca zasada: odczyt wykonuje model najtańszy, a drugi model stosuje się tylko tam, gdzie pierwszy nie zwrócił tekstu lub sygnalizuje niepewność.
Nie rekomendujemy przejścia na Sola ani stosowania wariantu high dla wszystkich stron: w teście zwiększył on koszt dziesięciokrotnie przy poprawie o 0,3 punktu procentowego.
12. Dalsze prace
- Własny zbiór referencyjny. 18 stron z zespołu oczekuje na korektę w przeglądarce. Dopiero ten zbiór pozwoli ocenić odczyt pisma z akt Kruszyńskiego, a nie kroniki zamojskiej.
- Kurrenta. 42 strony z Drezna zostały pobrane. Teksty niemieckie stanowią 30% stron rdzenia, a dla nich nie dysponujemy jeszcze żadnym pomiarem.
- Ustawienia bezpieczeństwa. Należy sprawdzić, czy jawne ustawienie
safetySettingsw API Gemini ogranicza liczbę przerwanych odczytów „Sekretów”. OpenRouter nie przekazuje tych ustawień. - Rozszerzenie zbioru TranskriBUW. Serwis zawiera więcej zatwierdzonych stron niż wykorzystano w teście (pozostałe strony „Connotacyi”, akt rozwodowych i KRWRiOP). Publikacja wyników z ich tekstem wymaga zgody BUW, ponieważ transkrypcje nie mają określonej licencji.
- Wskaźnik niepewności. Na zbiorze referencyjnym należy sprawdzić, czy rozbieżność dwóch odczytów Gemini lepiej przewiduje błędy niż samoocena. Od wyniku zależy, czy drugi odczyt wykonywać zawsze, czy warunkowo.
13. Inne modele i dostrajanie
Test objął trzy modele trzech dostawców. Do kolejnej rundy kwalifikują się modele z różnych segmentów rynku. Otwarte pozostaje także pytanie, czy zamiast wyboru gotowego modelu nie należy dostroić własnego na podstawie wykonanych korekt.
13.1. Modele do kolejnej rundy testów
- Wydajniejsze modele tych samych dostawców: Claude Opus 5.5 oraz wyższy model Gemini, jeśli zostanie udostępniony. Mogą odczytywać dokładniej, lecz przy kilkakrotnie wyższej cenie są uzasadnione jedynie jako drugi odczyt stron trudnych.
- Tańsze warianty: Claude Haiku 5.5 i tańsze modele GPT-6. W roli modelu zastępczego przy blokadach Gemini istotny jest przede wszystkim brak odmów; dokładność może być niższa.
- Otwarte modele wizyjno-językowe (np. rodzina Qwen-VL) i modele OCR dokumentów. Ich użycie na własnej infrastrukturze GPU jest tanie i nie podlega filtrom treści. Bez dostrojenia osiemnastowieczna polska kursywa pozostaje jednak poza zakresem ich możliwości.
- Klasyczne systemy HTR: Transkribus (modele „Polish M2”, „Polski Wieszcz”) oraz eScriptorium/Kraken. Rozpoznają tekst wiersz po wierszu, są bardzo tanie w eksploatacji i skuteczne przy jednej ręce w długich seriach. Nie interpretują układu ani treści, dlatego nie zastąpią etapu budowy grafu wiedzy.
13.2. Metody poprawy dokładności
Przykłady w poleceniu
- Dane
- 3–5 stron tej samej ręki z korektą
- Koszt
- więcej tokenów wejściowych przy każdym odczycie, bez treningu
- Zalety
- możliwe do sprawdzenia od razu, na każdym modelu
- Wady
- działa dla jednej ręki, nie dla całego zespołu; rośnie długość kontekstu
Dostrajanie modelu w chmurze
- Dane
- setki stron z korektą
- Koszt
- trening oraz wyższa cena odczytu modelem dostrojonym
- Zalety
- zachowane rozumienie treści i format JSON
- Wady
- dostępność dla modeli wizyjnych wymaga sprawdzenia u każdego dostawcy; filtry pozostają
Otwarty model z adapterem (LoRA)
- Dane
- 500–2 000 stron z korektą
- Koszt
- GPU na trening i odczyt, praca inżynierska
- Zalety
- brak filtrów i opłat za stronę, model pozostaje w projekcie
- Wady
- niższy poziom wyjściowy; konieczność własnych pomiarów i utrzymania
Klasyczny model HTR
- Dane
- tysiące wierszy z segmentacją
- Koszt
- niski w eksploatacji, wysoki przy przygotowaniu danych
- Zalety
- wysoka skuteczność dla jednej ręki w długiej serii
- Wady
- wyłącznie tekst; metadane, daty i osoby wymagają osobnego etapu
Najkorzystniejsze wydaje się połączenie tych metod. Gemini wykonuje tani odczyt całości. Korektorzy w „Stole archiwisty” poprawiają w pierwszej kolejności strony niepewne. Korekty służą do dostrajania otwartego modelu lub jako przykłady w poleceniu dla danej ręki. Po zgromadzeniu kilku tysięcy poprawionych stron własny model może przejąć powtarzalne serie (np. rejestry majątkowe Nawry), a duże modele pozostaną przeznaczone do przypadków trudnych i analizy treści. Warunkiem jest zapisywanie korekt ze „Stołu archiwisty” jako par obraz–tekst, co należy uwzględnić już na obecnym etapie.
14. Ograniczenia badania
- 30 stron i ok. 15 rąk to niewielka próba. Różnice poniżej 1–2 punktów procentowych w obrębie grupy mieszczą się w granicach błędu pomiaru.
- Transkrypcje referencyjne wykonali wolontariusze według przyjętych przez siebie zasad (np. w zakresie transkrypcji skreśleń). Część błędów modeli wynika z różnic konwencji. Polecenia nie dostosowywano do tych zasad.
- Sol wykonywał odczyty w trzech trybach (Flex, Batch, standardowy). Tryb nie wpływa na dokładność, lecz zmierzone czasy nie odzwierciedlają szybkości modelu; koszty podajemy w cenie standardowej.
- Ceny według stanu z 11–13 października 2026 r. Każdy odczyt jest pojedynczy; drugi odczyt i rozstrzyganie (stosowane w naszym potoku przetwarzania) zmniejszają błąd, lecz nie były przedmiotem tego pomiaru.
Źródła i licencje. Skany TranskriBUW: Biblioteka Uniwersytecka w Warszawie, domena publiczna. Transkrypcje TranskriBUW wykorzystano wyłącznie do obliczenia odsetka błędów i nie są tu przytaczane, z wyjątkiem jednego roku w zestawieniu obserwacji w sekcji 9. Skany i transkrypcje Wikiźródeł: Wikimedia Commons / Wikiźródła, CC BY-SA. Archiwum Sczanieckich z Nawry: Archiwum Państwowe w Toruniu, zespół 69/833/0.